Textual Memory
Long-context, persona, script, and conversation-memory benchmarks.
在统一评测流程下,对文本、多模态和编程智能体记忆系统进行比较的公开基准平台。
Each track keeps its own result table and detailed metric breakdown.
Long-context, persona, script, and conversation-memory benchmarks.
Memory retrieval and generation over image-rich or multimodal tasks.
Agent memory support for coding tasks and repository-context recall.
Open-source methods and commercial products both use participant-hosted Add/Search APIs. AML does not deploy repository-only submissions.
Operate publicly reachable Add/Search endpoints and submit the fixed API version for review.
Use the issued key to verify the synchronous Add/Search flow.
After smoke passes, submit the full scored evaluation.
Use the product pages to inspect rankings, run evaluations, and prepare an integration.
Public ranking with filters, dataset columns, and score bars.
Create eval jobs, watch progress, and inspect private results.
Eligibility, submission routes, required materials, timelines, rewards, and publication rules.
User guide, evaluation workflow, API contract, security, and result publication.
Add/search API contract, request fields, polling, and response schemas.
来自 Agent Memory Leaderboard 团队的研究、技术实践与最新动态。
提交 Full、已有任务续跑、实名及团队登记、结果复核与正式揭榜的关键时间安排。
围绕申请确认、版本登记、跨赛道接入、接口异常及模型资格,整理第二期参赛补充答疑。
AML 第二期公开评测已于 2026 年 9 月 20 日 00:00 开放。
倒计时 2 天|Agent Memory Challenge 2026 第二期参赛指南
相比文本记忆,Coding Memory 要回答的问题更加直接:过去开发过程中积累的经验,能不能真正帮助 Agent 完成后续的软件工程任务。
Agent Memory 没有唯一答案。
Agent Memory 没有唯一答案。
Agent Memory 没有唯一答案。
第二届 Agent Memory Challenge(Agent 记忆公开挑战赛)即将启动。本届挑战赛由中国图像图形学会(CSIG)主办,南京大学、浙江大学、Datawhale、CSIG 企业联络与标准化工作委员会承办,并依托Agent Memory Leaderboard(AML)统一评测平台,完成报名、评测、结果复…
Agent Memory 没有唯一答案。
Agent Memory 没有唯一答案。
榜前都是好汉,榜上各有绝活。
重磅!Agent Memory Leaderboard 首期榜单正式揭晓
如果一个 AI Agent 每次交流都像第一次见面,它真的算“智能”吗?
随着 Agent 从一次性问答工具走向长期协作系统,长期记忆正在成为决定其可靠性、个性化能力与工程可用性的关键基础设施。
记忆之巅排行榜
今天,Agent Memory Leaderboard(AML,记忆之巅排行榜)首期榜单正式揭晓。
随着 Agent 从单轮问答走向长期协作,记忆已不再只是附加功能,而是持续理解用户、积累经验并完成复杂任务的基础能力。如何在统一条件下衡量这项能力,正成为研究与产业共同面对的问题。
AML 由来自国内外 20 余所高校、科研机构与开源社区的研究者和团队联合发起,致力于构建面向 Agent Memory 的开放评测体系与长期公榜。首期评测覆盖开源方法与商业产品,所有进入正式榜单的系统版本均在统一的流程与规范下完成测试与复核。
截止到2026年8月12日12时,AML官方站点点击量突破20万次,其中,赛事页面上线十天内点击量即突破10万次,全网各平台引发热烈讨论,累积收到136个团队提交注册申请。
🏆 首期榜单正式公布
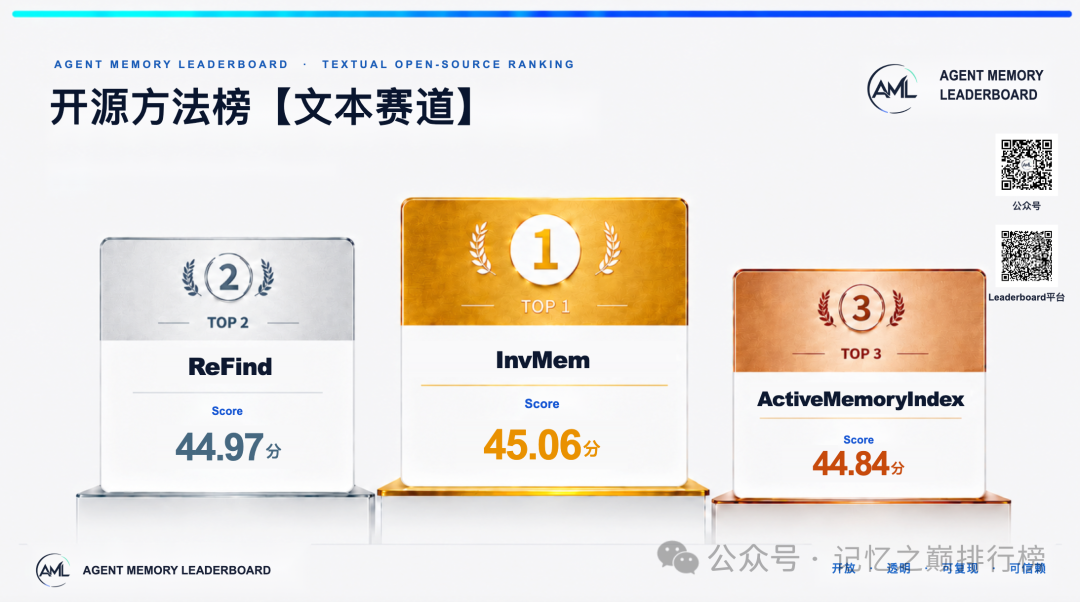
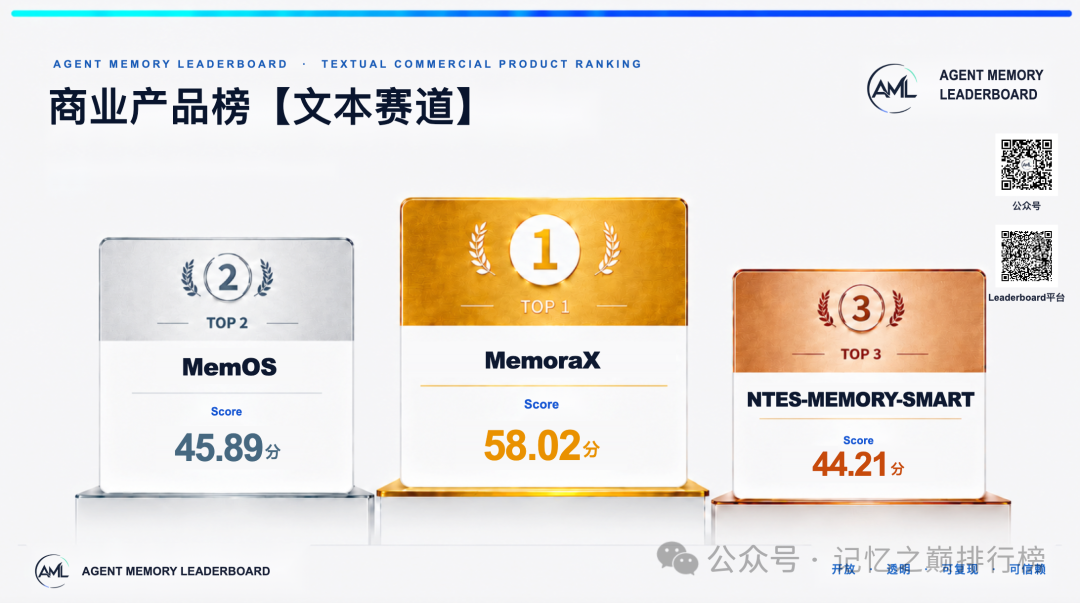
经过严格的筛选与测试,首期共有 67 个极具代表性的记忆框架成功完成评测任务,首期榜单正式公布文本赛道结果。榜单分为开源方法、商业产品两组参评通道:
▍开源方法榜【文本赛道】
▍商业产品榜【文本赛道】
完整排名、分项成绩及版本信息,点击文末“阅读原文”榜单页面。
本榜单由 AML 官方发布。文中名次、分数与结论仅在对应参评组别、系统版本、评测套件和当期规则范围内成立。
⚙️ 同一套流程,让结果真正可比
过去,不同记忆系统常采用不同的数据集、回答模型和评分方式,公开成绩难以直接比较。
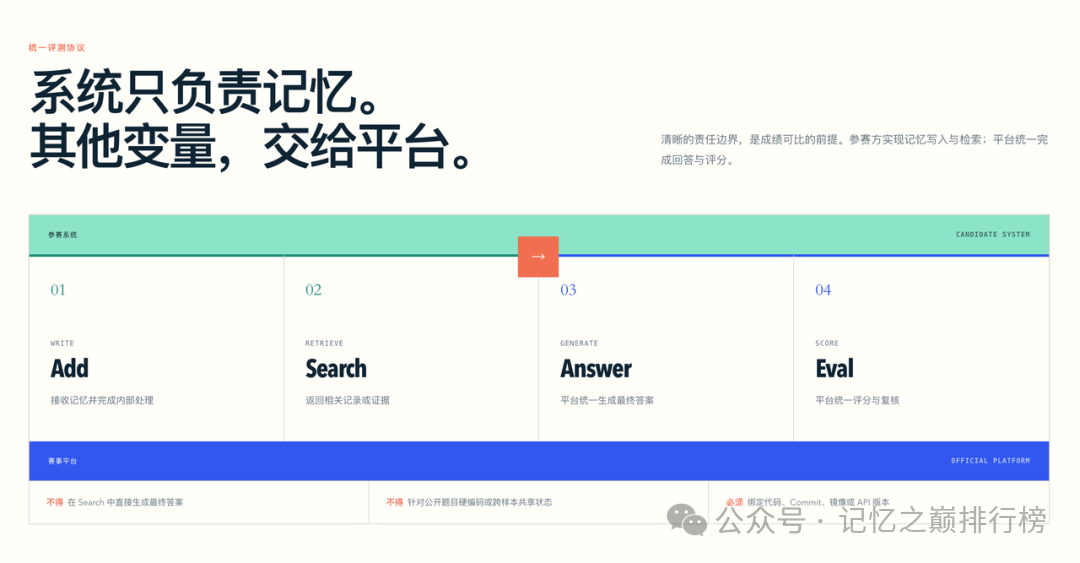
AML 将参评系统的核心边界统一为 Add(写入记忆)与 Search(检索记忆),并由平台统一完成 Answer(基于检索结果生成回答)、Eval(评分)、结果汇总与发布复核。这种解耦机制能最大程度减少因选择不同回答模型、评分模型或统计口径带来的干扰,让评测结果在明确的边界内真正具备可比性与公信力。
🧭 不只看名次,更要看能力结构
记忆能力不等于简单的信息召回。在文本记忆任务中,AML 关注显式事实召回、关系与多跳组合、时间与事件序列、记忆治理、个性化与关怀、规则与流程执行、认识论安全与隐私等能力。
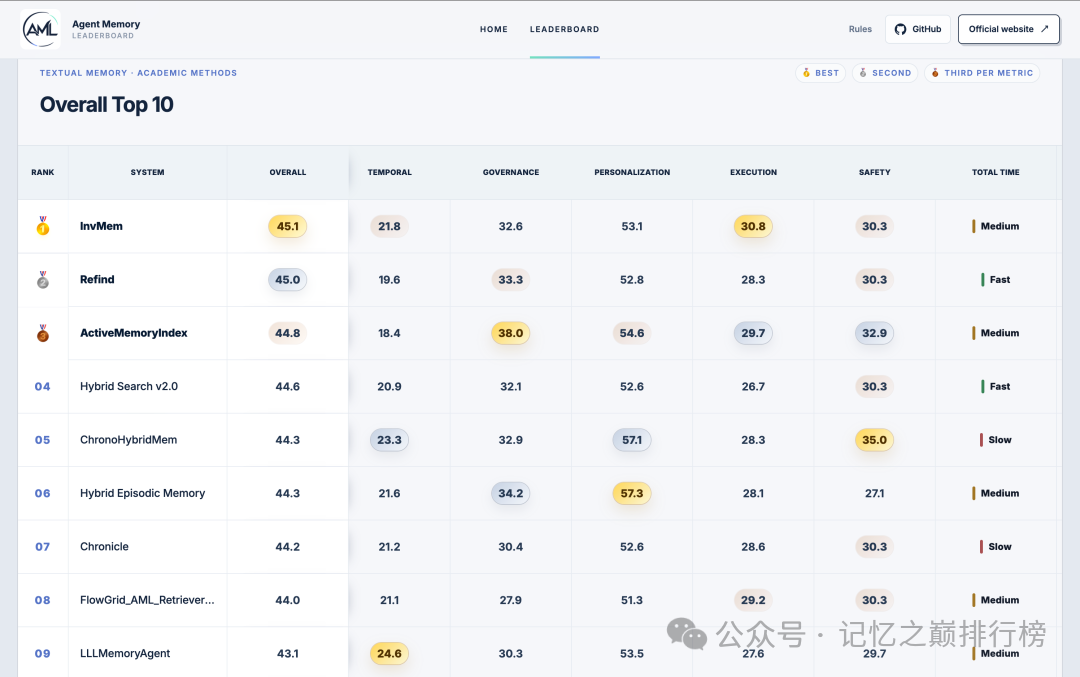
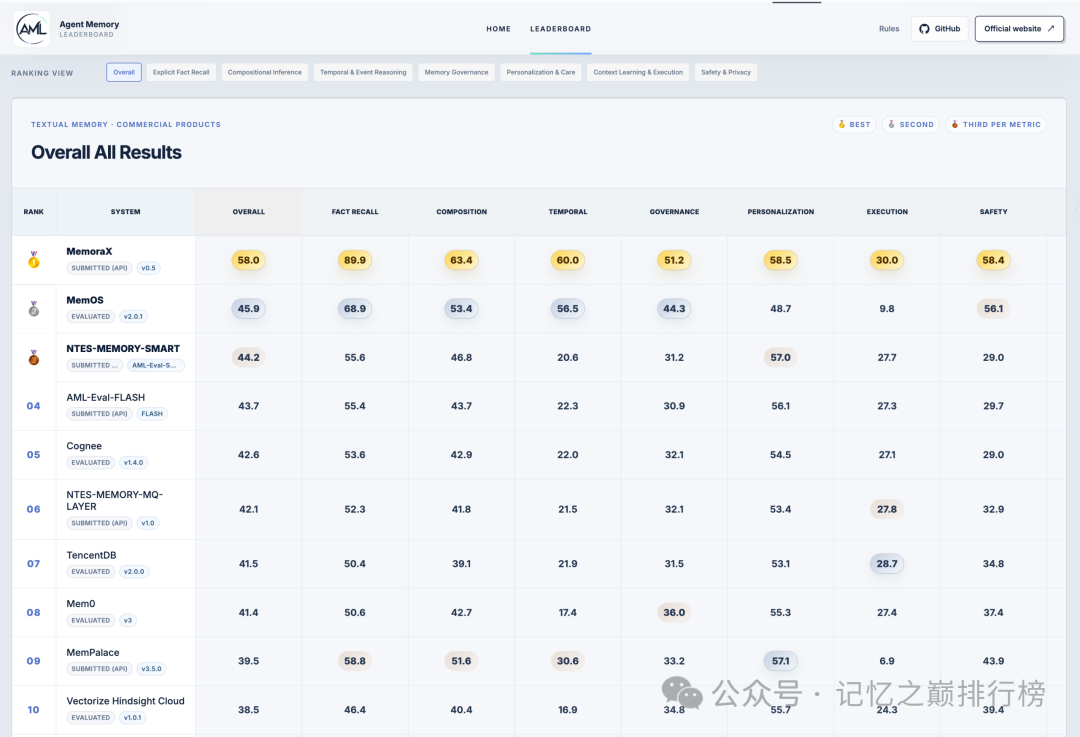
榜单的发布并非终点,而是探索记忆本源的全新起点。接下来,AML 将持续推出一系列深度解读专栏。我们将抽丝剥茧,深入剖析本次评测中涌现出的典型技术架构与极具启发性的实验现象,对各个关键能力象限的得分表现进行技术复盘,助力广大开发者透过榜单数字,洞悉 Agent Memory 技术演进的底层脉络与未来趋势。
AML 官方评测与榜单保持常态化运行,评测通道持续开放。我们诚邀全球学术界研究团队与工业界开发者提交参评方案;同时,也热烈欢迎社区同仁向 AML 提交全新的 Benchmark 数据集与评测任务,共同拓宽 Agent 记忆能力的标准边界!
AML首期赛事入选上榜奖励和社区贡献计划入选奖励的团队,我们会在8月31日之前与大家取得邮件联系,请大家关注。
感谢所有参评团队、数据与评测方法贡献者,以及关注 Agent Memory 发展的研究者和开发者!
让记忆能力可衡量,让技术进步可验证。
📧 联系与合作:欢迎通过 GitHub Discussion 或官方邮箱与评测组取得联系。
公开排名按赛道区分。使用排行榜内的选择器切换表格,避免混合不同的指标维度。
公开排名按赛道区分。使用排行榜内的选择器切换表格,避免混合不同的指标维度。
公开排名按赛道区分。使用排行榜内的选择器切换表格,避免混合不同的指标维度。
材料提交已截止。已提交 API 端点的任务将由后台陆续安排 Full。请登录查看任务进度、按原规则断点续跑及查看私有结果。正式评测截止为 2026 年 11 月 4 日 23:59(UTC+8),随后约两天视实际情况尽可能处理未完成任务及异常重试,请保持 API 可用。
Choose a bound version. Use Run label to distinguish repeated evaluations of the same version.
Confirm each item before starting a public-board candidate run. The button remains locked until every item is checked.
Live job status and progress.
Review completed Full runs from non-admin leaderboard keys. Approved results enter the public board; rejected results remain private.
Private scores stay scoped to the current leaderboard key. Admin runs remain separate from external review candidates.
Agent Memory Challenge 是 Agent Memory Leaderboard 的第二期公开评测活动,面向全球研究者、开源项目维护者和商业产品团队开放。参赛系统负责 Add 与 Search,平台统一完成 Answer、Eval、结果复核与公榜。
参赛免费,不设组队要求。参赛方承担自身 API、数据库、带宽和计算成本,平台承担统一 Answer、Eval 与评测编排成本。
2026 年 9 月 20 日 00:00
2026 年 10 月 31 日 23:59(UTC+8)
2026 年 11 月 4 日 23:59(UTC+8)
预计 2026 年 11 月 19 日
文本、代码与多模态记忆
评测类型决定系统接受什么任务;参赛组别决定结果展示在哪个榜单。两者是互相独立的两个维度。
| 评测类型 | 主要评测内容 | 可选参赛组别 | 第二期时间 |
|---|---|---|---|
| 文本记忆 | 长对话、跨会话历史、事实、多跳关系、时间事件、个性化、规则与记忆治理,并纳入 Streaming 持续记忆能力。 | 开源方法榜 / 商业产品榜 | 10 月 31 日 23:59 材料截止 |
| 代码记忆 | Agent 对同仓库历史工程经验的检索、筛选和复用能力,分别评测 relevant 与 noisy 条件。 | 开源方法榜 / 商业产品榜 | 10 月 31 日 23:59 材料截止 |
| 多模态记忆 | 图文记忆的写入、检索与证据使用能力,支持文本和 Base64 图片有序内容数组。 | 开源方法榜 / 商业产品榜 | 10 月 31 日 23:59 材料截止 |
第二期所有参赛组别都必须由参赛方自行部署 Add / Search API。Eval Key 是在线接口申请审核通过后获得的评测凭证。
提交固定版本、Add / Search 地址、鉴权方式和运行说明;公开仓库作为开放性与署名材料,不能替代在线接口。
提交固定产品版本、Add / Search 地址、鉴权和容量说明。无需公开内部实现,审核通过后获得 Eval Key,结果进入商业产品榜。
开源方法榜和商业产品榜都只通过参赛方自托管的 Add / Search API 接入。第二期不接受只提交 GitHub 仓库、Docker 镜像或启动说明并由 AML 代为部署。开源材料仍用于开放性、署名和复现审核。
请在提交申请前固定参评版本。正式 Full 评测受理后,不得因结果不理想更换版本或撤回。
系统名称与版本、联系人、机构或团队、拟参评类型、方法或产品说明、允许公开展示的信息,以及完整的提交说明。
已部署的 Add / Search API、鉴权与容量声明,以及公开仓库、固定 commit、原始工作引用和方法改动说明。
固定产品版本、Add / Search API、鉴权方式、评测专用密钥、容量限制、超时与限流说明。
选择评测类型和参赛组别,提交已部署的 Add / Search API、系统版本与完整材料。
平台审核在线接口和提交材料,通过后签发 Eval Key;AML 不代为部署参赛系统。
先验证 Add / Search、鉴权和端到端链路,再运行第二期正式 Full 评测。
平台复核版本、结果和合规状态,通过后发布到对应公开榜单。
两个 Key 的签发方和用途不同,请勿将它们放入公开仓库、URL、截图、邮件正文或群聊。
| 凭证 | 谁提供 | 用途 | 谁需要 |
|---|---|---|---|
| Eval Key / Leaderboard Key | Agent Memory Leaderboard | 验证参赛身份、运行评测并查看私有结果。 | 提交自托管 Add / Search API 并审核通过的开源方法榜及商业产品榜参赛者。 |
| Memory System Key | 参赛方 | 供平台访问参赛系统的 Add / Search API。 | 接口启用鉴权时需要;无鉴权接口无需提供。 |
第二届 Agent Memory Challenge 面向文本、代码与多模态三个赛道设置合计人民币 150,000 元奖金池。奖金仅面向符合赛事规则并通过审核的开源方法榜参赛团队,商业产品榜不参与奖金评选。
奖金人民币 20,000 元。文本、代码与多模态三个赛道分别评选。
二等奖 2 名,每名人民币 8,000 元;三等奖 3 名,每名人民币 3,000 元。
奖金人民币 5,000 元。每个赛道奖金合计 50,000 元,三个赛道合计 150,000 元。
参赛身份、系统版本和所需材料均完整、真实且可核验。
Add / Search、鉴权和端到端链路符合现行接入协议。
正式评测任务和所需评测项成功完成,没有缺失或重复结果。
正式评测使用的代码、镜像或 API 与申报版本保持一致。
版本、结果与合规状态通过主办方审核,方计为一次有效提交。
Search 不得直接生成最终答案,也不得把答案伪装为记忆记录。
不得跨 user_id、任务、样本或团队共享和检索评测记忆。
复用论文、仓库或代码时,必须注明原作者、技术报告和全部方法改动。
严禁硬编码、数据泄漏、提示词注入、人工实时答题、结果操纵和恶意刷榜。
提交申请前请先阅读 API 接入指南并准备完整材料。报名与评测问题可发送至 [email protected]。
Agent Memory Challenge is the second public evaluation cycle of Agent Memory Leaderboard. It is open to researchers, open-source maintainers, and commercial product teams worldwide. Participants provide Add and Search; the platform runs Answer, Eval, result review, and leaderboard publication.
Participation is free, with no team-size requirement. Participants cover the cost of their own APIs, databases, bandwidth, and compute; the platform covers unified Answer, Eval, and evaluation orchestration.
September 20, 2026 · 00:00 (UTC+8)
October 31, 2026 · 23:59 (UTC+8)
November 4, 2026 · 23:59 (UTC+8)
Expected November 19, 2026
Textual, Coding, and Multimodal Memory
The evaluation type determines the tasks your system receives; the participant division determines where the result is listed. These are two independent dimensions.
| Evaluation type | What it evaluates | Available divisions | Cycle 2 schedule |
|---|---|---|---|
| Textual Memory | Long conversations, cross-session history, facts, multi-hop relations, temporal events, personalization, rules, memory governance, and Streaming memory. | Open-source Methods / Commercial Products | Materials close October 31 at 23:59 |
| Coding Memory | Retrieving, filtering, and reusing engineering experience from the same repository under relevant and noisy conditions. | Open-source Methods / Commercial Products | Materials close October 31 at 23:59 |
| Multimodal Memory | Writing, retrieving, and using evidence from text-and-image memories through ordered text and Base64 image content arrays. | Open-source Methods / Commercial Products | Materials close October 31 at 23:59 |
In Cycle 2, every participant division must host stable Add / Search APIs. An Eval Key is issued after the submitted online endpoints and materials pass review.
Submit fixed Add / Search endpoints, authentication and operational details. A public repository supports openness and attribution review but cannot replace deployed endpoints.
Submit a fixed product version, Add / Search endpoints, authentication, and capacity details. Internal implementation may remain closed; an Eval Key is issued after approval and results enter the Commercial Products board.
Open-source and commercial entries integrate through participant-hosted Add/Search APIs. Cycle 2 does not accept repository-only or Docker-only submissions for AML deployment. Open-source materials remain part of openness and attribution review.
Freeze a clear evaluation version before applying. Once a formal Full evaluation is accepted, the version may not be replaced or withdrawn because of an unfavorable result.
System name and version, contact details, organization or team, intended evaluation type, method or product description, information approved for public display, and complete submission notes.
Deployed Add/Search endpoints, authentication and capacity declarations, plus a public repository, fixed commit, attribution of prior work, and method changes.
Fixed product version, Add / Search APIs, authentication, a dedicated evaluation credential, capacity, timeout, and rate-limit details.
Choose an evaluation type, participant division, and submission route, then provide a fixed system version and complete materials.
The platform reviews the live API and submitted materials, then issues an Eval Key. AML does not deploy participant systems.
Validate Add / Search, authentication, and the end-to-end path before the formal Cycle 2 Full evaluation.
The platform reviews the version, results, and compliance status before publishing the entry to its corresponding public board.
These credentials are issued by different parties and serve different purposes. Never place either credential in a public repository, URL, screenshot, email body, or group chat.
| Credential | Provided by | Purpose | Who needs it |
|---|---|---|---|
| Eval Key / Leaderboard Key | Agent Memory Leaderboard | Verifies participant access, starts evaluations, and unlocks private results. | Open-source and commercial participants whose self-hosted Add / Search APIs pass review. |
| Memory System Key | Participant | Allows the platform to call the participant's Add / Search APIs. | Required when the submitted API uses authentication; not required for an unauthenticated endpoint. |
The second Agent Memory Challenge provides a total prize pool of US$22,000 across the Textual, Coding, and Multimodal tracks. Prizes are available only to eligible Open-source Methods teams that pass review; Commercial Products entries are not eligible.
≈ USD 3,000. The Textual, Coding, and Multimodal tracks are judged separately.
Second Prize: 2 winners, ≈ USD 1,200 each. Third Prize: 3 winners, ≈ USD 450 each.
≈ USD 750. The total prize pool across all three tracks is US$22,000.
Participant identity, system version, and all required materials are complete, truthful, and verifiable.
Add / Search, authentication, and the end-to-end path follow the current integration contract.
The formal evaluation and required tasks complete successfully without missing or duplicated results.
The code, image, or API used for the formal evaluation matches the declared version.
The version, results, and compliance status pass organizer review before the submission is considered valid.
Search must not generate final answers or disguise answers as memory records.
Do not share or retrieve evaluation memories across user IDs, tasks, samples, or teams.
When reusing a paper, repository, or codebase, identify the original authors, technical report, and every method change.
Hard-coding, data leakage, prompt injection, live human answering, result manipulation, and leaderboard abuse are prohibited.
Read the API Guide and prepare all required materials before applying. For participation and evaluation questions, contact [email protected].
了解如何接入 Add / Search、运行统一评测、查看结果,并将符合条件的结果发布到公开榜单。
OVERVIEW
Agent Memory Leaderboard 使用统一的端到端流程评估不同记忆系统。数据库、索引和内部架构不作限制。开源方法榜(学术榜)的 Embedding 模型须使用 text-embedding-v4,LLM 相关组件须使用 gpt-4o-mini;Reranker 不作限制。商业产品榜(工业榜)不受上述模型限制。Add / Search 接口须符合现行规范,评测过程和检索结果须能够复核。
我们按样本和来源会话调用 Add 接口。
你的系统负责持久化、组织、索引和更新记忆。
我们针对每道题调用 Search 接口并接收排序结果。
我们使用固定流程生成答案、完成评分并汇总结果。
你只负责 Add / Search 环节。回答模型、提示词、评分器、数据集组合、Top K 和汇总规则由我们统一固定,使榜单分数尽可能反映记忆系统本身的能力。
WHO THIS IS FOR
你可以在 Textual、Multimodal 或 Coding Track 中查看 Overall、分项指标、系统版本和发布日期。不同 Track 使用的任务和指标不同,分数不宜跨 Track 直接比较。
实现 Add / Search → 提交准入申请 → 获取 API Key → 运行公开 smoke → 提交 full 正式评测 → 查看私有结果 → 进入公榜审核。
PARTICIPATION WORKFLOW
先提交 Evaluation Access Request,完成参测系统、版本、在线 Add / Search 接口和鉴权方式审核。第二期所有榜单均要求参赛方自行部署接口,AML 不接受仅提交仓库后代为部署。
选择申请新 Key,或输入已有 Key 为其增加版本;填写联系人、系统版本、Add / Search 接口、鉴权、容量和运行限制。开源方法另附仓库与来源披露。
审核通过后,新申请会签发 Leaderboard API Key;新增版本申请会直接绑定到原 Key,无需管理员再次手工录入接口信息。
平台直接校验参赛方提交的在线接口,并按照现行同步规范执行 Add → Search → Answer → Evaluate Smoke 流程,确认接口可用后再进入正式评测。
选择 full 前,必须逐项勾选提交清单:smoke 已通过、API 契约正确、运行说明完整,以及原创性披露和诚信承诺均已完成。
在 Evaluation 页面验证 API Key,选择已绑定的版本,填写唯一的 Run Label 后提交 full 评测。正式任务使用统一的数据集套件和 Top K。
任务依次执行写入、检索、回答、评分和结果汇总。页面会显示当前阶段、完成进度和错误摘要;我们同时保留复核所需的过程记录。
评测结果首先仅对绑定的 API Key 可见。成功完成的 full 任务会进入公榜资格校验和审核队列;审核通过后生成公榜提交记录。
允许复现已有论文或封装已有仓库,但必须披露原始作者、技术报告以及方法改动;未披露的重复代码可能被视为抄袭。发现重复代码时,平台会优先保护本人已披露并先提交的评测结果。重复提交相似或低质量代码、提示词注入、数据或结果操纵、恶意刷榜等行为,均可能取消参赛资格。
EVALUATION MODES
| 模式 | 用途 | 标准配额 | 结果范围 | 公榜资格 |
|---|---|---|---|---|
| smoke | 通过独立的兼容性测试接口检查同步 Add、Search 和评分链路。 | 每小时 1 次;本届每赛道最多 30 次 | 仅私有 | 不可发布 |
| full | 运行固定的完整评测套件,并进入正式排队、审计和发布流程。 | 本届每个 AML Key、每个赛道最多 2 次;第 2 次须在首次 Full 完成后 30 天发起 | 优先私有 | 审核通过后发布 |
首次接入或接口行为变更后,先使用独立的兼容性 smoke 检查接口规范;接口稳定且版本准备完成后,再提交唯一的正式评测模式 full。
ADD / SEARCH CONTRACT
参赛选手配置 Add 和 Search 的接口地址,请求和响应格式按照现行规范固定,不随 URL 路径变化。生产环境建议使用 HTTPS。URL 中不得包含用户名、密码等凭据,也不得指向私有、回环或链路本地地址。
记忆写入完成后,Add 接口返回 HTTP 200
返回数量不得超过 top_k,超量会判为契约错误
Add 和 Search 必须使用完全相同的 user_id
Add / Search 支持 Token、Bearer 和 X-Api-Key;none 仅用于公开 smoke。Health 接口通过无需鉴权的 GET 请求调用,返回任意 2xx 状态码即表示服务正常。
普通文本在达到 20 条消息或 2,000 个词中的任一边界时确定性分段,词数按冻结 Adapter 计数;Streaming 按增量会话/任务单元写入;代码保留仓库/会话轨迹,多模态按公开数据源单元与媒体限制处理。单次请求最长 30 分钟。
{
  "request_id": "eval:run_abc123:locomo_refined:conv-0:chunk-0",
  "messages": [{
    "role": "user",
    "timestamp": 1704067200000,
    "content": "memory text"
  }],
  "user_id": "eval:run_abc123:locomo:conv-0",
  "session_id": "eval:run_abc123:sample:0"
}request_id必填。本次写入请求的唯一标识;成功响应必须原样返回该值。
messages必填。消息按原顺序排列,每条消息包含 role 和非空 content。文本与代码使用字符串;多模态可使用字符串或有序 text/image_url 内容数组。timestamp 可选,单位为 Unix 毫秒。
user_id必填。Search 接口唯一使用的检索范围标识;写入和检索时必须保持一致。
session_id必填。用于标识来源会话,可以用于组织记忆,但不作为 Search 的筛选条件。
未使用字段现行规范不发送 metadata、app_id、agent_id 或 async_mode;同步语义由 Add 完成写入后返回 HTTP 200 保证。
写入完成并且相关记忆能够立即检索后,才能返回成功响应。
HTTP 200
{
  "success": true,
  "request_id": "eval:run_abc123:locomo_refined:conv-0:chunk-0",
  "user_id": "eval:run_abc123:locomo:conv-0",
  "session_id": "eval:run_abc123:sample:0"
}success必填,且必须是布尔值 true。
request_id / user_id / session_id全部必填,并且必须与请求中的值完全一致。
同步完成服务内部可以采用异步处理,但 Add 接口必须等待处理完成后再返回。
HTTP 202仅当提交版本已审核绑定包含 {task_id} 的 Add 状态查询地址时支持;响应须返回 task_id。未绑定时返回 202 属于契约错误。响应不需要 memory_ids。
平台按赛道流程发起 Search;Streaming 可在多个增量节点检索同一道题。查询使用基准原文;多模态可使用图片内容数组,选择题在顶层另行传入选项。单次请求最长 30 分钟。
{
  "query": "Which answer best matches the memory?",
  "options": ["A. First answer", "B. Second answer"],
  "user_id": "eval:run_abc123:locomo:conv-0",
  "top_k": 100
}query必填。按照原文检索相关记忆;多模态可使用与 Add 相同的 text/image_url 内容数组。不得替换为最终答案或使用评测金标。
options可选。选择题(含 Streaming)在 Search 顶层传入选项文本数组;开放题不发送,不包含金标答案。
user_id必填。只能在该 user_id 对应的记忆范围内检索。
top_k必填。返回的记忆数量不得超过该值;正式外部评测固定为 100。
请求格式现行规范不发送 filters、rerank 或 keyword_search。
响应必须是一个 JSON 对象,其中 data 为按相关性排序的数组。没有检索结果时,返回空数组。
{
  "data": [{
      "id": "mem_1",
      "content": "remembered fact text",
      "score": 0.87,
      "created_at": "2026-07-01T12:00:00Z"
  }]
}data必填,类型为数组。不要增加 items 包装层,也不要直接返回顶层数组。
id必填,非空字符串,用于稳定标识该条记忆。
content必填,非空字符串;多模态可返回 text/image_url 内容数组。平台保留原始候选并传入统一 Answer 流程。
score可选,数值类型。数值越大应表示相关性越高。
created_at可选,用于记录记忆的来源时间或持久化时间。
其他字段我们只读取上述字段;metadata 等未声明字段会被忽略。
ERROR HANDLING
参测接口应使用标准 HTTP 状态码,并返回便于排查问题且不含密钥的错误信息。平台业务错误通常采用 {"detail":{"reason":"..."}} 格式;字段校验失败时,HTTP 422 会返回结构化错误明细。
| HTTP | 错误类型 | 常见原因 | 处理方式 |
|---|---|---|---|
400 / 422 | 接口格式错误 | Add / Search 请求无法解析,或者成功响应缺少必填字段、字段类型不正确。 | 不自动重试。根据错误信息修正请求或响应格式,然后重新运行 smoke。 |
401 | 认证失败 | Memory System Key 无效,或者 Authorization / X-Api-Key 与申请时选择的方式不一致。 | 不自动重试。核对鉴权方式和绑定的密钥。 |
403 | 访问被拒绝 | 当前密钥无权调用接口,或者服务端拒绝访问指定的 user_id。 | 不自动重试。检查接口权限和检索范围配置。 |
404 | 资源不存在 | 接口路径错误,或者平台侧的 test、job、result ID 无效。 | 检查 URL 或资源 ID。现行同步规范不包含 Add Status 查询。 |
409 | 状态冲突 | 同一 Add 可能仍在处理,或者平台已有任务正在运行、Run Label 重复。 | Add 可保持同一 request_id 与请求体进行有界重试,但不能仅凭 409 视为成功;Search 的 409 不重试。平台任务冲突时,请等待现有任务结束或更换 Run Label。 |
408 / 425 | 暂时不可用 | 请求超时,或者服务尚未准备完成。 | Add / Search 请求都会按照平台策略进行有限次数的退避重试。 |
429 | 触发限流或配额 | 参测接口容量不足,或者平台评测配额尚未恢复。 | 接口调用会在限定次数内重试;如果是平台配额限制,请等待页面显示的下次可用时间。 |
500 / 502 / 503 / 504 | 临时服务异常 | 参测接口、网关或上游依赖暂时不可用。 | 我们会自动退避重试。若持续失败,请保留 Job/Test ID 和发生时间,便于进一步排查。 |
Add 遇到网络错误及 408、409、425、429、500、502、503、504、524 时会有界重试;409 不单独代表成功。Search 遇到网络错误及 408、425、429、500、502、503、504 时会有界重试;400、401、403、404、409、422 等永久性 4xx 不重试。重试和断点续跑保持同一 Add 的 request_id 与请求体。
即使 HTTP 状态码为 200,只要 Add 未返回 success=true、三个 ID 未正确返回,或者 Search 未返回 data 数组、某条记录缺少 id / content,当前阶段都会立即失败。
DATA, SECURITY & PRIVACY
你的接口只会收到当前任务所需的记忆片段、user/session 标识和检索问题。我们不会提供金标答案、评分依据或完整数据集下载。
user_id 是 Search 接口唯一使用的检索范围标识,存储和检索时必须完全一致。session_id 只用于组织来源会话。禁止跨 user_id 返回记忆。
Memory System Key 通过受控的申请流程提交并加密保存,任务信息中只保留不可读的引用。密钥不会出现在邮件、公榜或公开 API 响应中。
我们只连接通过网络校验的公开 HTTP(S) 接口,并拒绝 URL 中包含凭据,或者指向私有、回环、链路本地地址的目标。
我们会保留复核所需的请求结果、耗时、错误、候选记忆和接口格式校验记录,用于确认评测是否完整,以及结果是否符合公榜条件。
私有任务和结果仅对绑定的 Leaderboard API Key 可见。公榜只展示审核通过的系统、版本、分数和必要的评测信息。
评测数据及其派生副本只能用于完成当前任务,不得用于模型训练、微调、产品分析、数据集重建或对外传播。请仅向必要人员开放访问权限,避免记录不必要的请求正文,并在任务完成后 30 天内删除相关数据;如需延长保留时间,必须事先获得我们的书面同意。
EVALUATION & RESULTS
每个记忆分块都必须在返回 HTTP 200 前完成持久化,并且能够立即检索。
我们会检查 data 数组、必填字段和 Top K,并按照接口返回的顺序接收候选记忆。
通过校验的候选记忆会进入统一的回答模型和提示词流程。
我们按照题型使用固定的评分规则,并汇总各数据集和 Overall 结果。
任务完成后,你可以使用绑定的 API Key 查看运行状态、分项结果、错误摘要和任务信息。
full 结果通过资格校验和审核后,会生成公榜提交记录并展示在公开榜单中。
结果必须来自成功完成的 full 模式固定套件,且所有评测任务均执行成功。统一回答模型、评测规范、pipeline code hash、dataset bundle hash 和题量记录必须完整,并与现行发布基线一致。结果不得重复提交,同时还需通过平台审核。
BENCHMARK SUITE
按能力维度浏览基准数据集。每张卡片均链接到源仓库,并说明任务格式、指标与评测备注。
Learn how to integrate Add / Search, run consistent evaluations, review results, and publish eligible runs to the public leaderboard.
OVERVIEW
Agent Memory Leaderboard compares memory systems under a consistent end-to-end evaluation. Databases, indexes, and internal architectures are unrestricted. Open-source Methods (Academic) entries must use text-embedding-v4 for embeddings and gpt-4o-mini for LLM-related components; rerankers are unrestricted. Commercial Products (Industry) entries are not subject to these model restrictions. The external Add/Search API and retrieval evidence must be conformant and auditable.
The platform calls Add by sample and source session.
Your system persists, organizes, indexes, and updates memory.
The platform calls Search per question and receives ranked results.
A fixed platform workflow generates answers, scores them, and aggregates results.
Participant-controlled behavior is limited to Add / Search. The platform locks the answer model, prompts, evaluators, dataset suite, Top K, and aggregation rules so that score differences primarily reflect the memory system.
WHO THIS IS FOR
Review Overall scores, metric breakdowns, system versions, and publication dates within the Textual, Multimodal, or Coding track. Each track has a distinct task and metric contract; scores are not comparable across tracks.
Implement Add / Search → submit an access request → receive an API Key → run public smoke → submit the full evaluation → review private results → enter public review.
PARTICIPATION WORKFLOW
Open-source Methods and Commercial Products submissions both use participant-hosted Add/Search APIs and follow the same review, Key issuance, and public Smoke flow. AML does not deploy repository-only submissions.
All entries provide deployed Add/Search endpoints, authentication, capacity, and operational details. Open-source Methods entries additionally disclose the public repository, original authors, technical report, and method changes.
Approval either issues a new Leaderboard API Key or binds the submitted version to the verified existing key without administrator re-entry.
The platform checks the participant-operated endpoints and runs the synchronous Add → Search → Answer → Evaluate Smoke flow. AML does not build or deploy participant systems.
Before selecting full, confirm the interactive checklist: smoke passed, API contract followed, run instructions complete, original work disclosed, and no integrity violations.
Verify the API Key on the Evaluation page, select a bound version, assign a unique Run Label, and submit the full evaluation. Formal jobs use the fixed suite and platform Top K.
The job proceeds through ingestion, retrieval, answering, scoring, and aggregation. The interface reports stage, progress, and error summaries while the platform retains evidence required for review.
Results are initially visible only to the bound API Key. A successful full job enters the public-eligibility gate and review queue; approval creates a public submission.
Reproductions of papers or existing repositories are allowed only with full attribution to the original authors, technical report, and all method changes. Undisclosed reuse may be treated as plagiarism. When duplicate code is discovered, the platform prioritizes the participant's first disclosed submission. Repeated near-duplicate or low-quality code, prompt injection, benchmark or result manipulation, malicious behavior, and other leaderboard abuse may cancel eligibility.
EVALUATION MODES
| Mode | Purpose | Standard quota | Visibility | Public eligibility |
|---|---|---|---|---|
| smoke | Separate integration endpoint for synchronous Add, Search, and scoring compatibility. | 1 per hour; at most 30 per track this edition | Private | Not eligible |
| full | Fixed complete benchmark suite with formal queueing, audit, and release workflow. | At most 2 Full runs per AML Key and track; the second unlocks 30 days after the first Full run is completed | Private first | Eligible after approval |
Use the separate compatibility smoke after initial integration or an API behavior change. Submit full, the only formal participant mode, after the version is ready for publication.
ADD / SEARCH CONTRACT
Participants configure the Add and Search URLs; request and response schemas are fixed and do not vary by path. Production deployments should use HTTPS. URLs must not embed credentials or resolve to private, loopback, or link-local addresses.
Add succeeds only with HTTP 200 after persistence
The response must not exceed top_k; excess items are a contract error
Add and Search must use the identical isolation boundary
Add / Search support Token, Bearer, and X-Api-Key; none is limited to public smoke. Health is an unauthenticated GET where any 2xx means healthy.
Ordinary Textual splits deterministically at either 20 messages or 2,000 Adapter-counted words. Streaming writes frozen incremental session or task units. Coding preserves repository/session trajectories; Multimodal follows published source units and media limits. One request may run for up to 30 minutes.
{
  "request_id": "eval:run_abc123:locomo_refined:conv-0:chunk-0",
  "messages": [{
    "role": "user",
    "timestamp": 1704067200000,
    "content": "memory text"
  }],
  "user_id": "eval:run_abc123:locomo:conv-0",
  "session_id": "eval:run_abc123:sample:0"
}request_idRequired. Unique identifier for this chunk request; the success response must echo it exactly.
messagesRequired ordered array. Each item includes role and non-empty content. Textual and Coding use strings; Multimodal may use strings or ordered text/image_url content parts. timestamp is optional Unix milliseconds.
user_idRequired. The sole retrieval-isolation field; Search must use the identical value.
session_idRequired. Identifies the source session and may be used for grouping, but is not a Search filter.
Fields not sentThe current contract omits metadata, app_id, agent_id, and async_mode. Synchronous behavior is guaranteed by returning HTTP 200 only after Add completes.
Return success only after the write is persisted and immediately searchable.
HTTP 200
{
  "success": true,
  "request_id": "eval:run_abc123:locomo_refined:conv-0:chunk-0",
  "user_id": "eval:run_abc123:locomo:conv-0",
  "session_id": "eval:run_abc123:sample:0"
}successRequired and must be the boolean value true.
request_id / user_id / session_idAll are required and must match the request byte for byte.
Synchronous completionInternal work may be asynchronous, but the endpoint must wait for completion before responding.
HTTP 202Supported only when the submitted version has an approved Add-status URL containing {task_id}; the response must return task_id. Without that binding, 202 is a contract error. memory_ids are not required.
The platform issues Search calls according to each track's workflow; Streaming may search the same question at multiple incremental steps. Questions retain their original language. Multimodal may use image content parts; choice options appear separately at the top level. One request may run for up to 30 minutes.
{
  "query": "Which answer best matches the memory?",
  "options": ["A. First answer", "B. Second answer"],
  "user_id": "eval:run_abc123:locomo:conv-0",
  "top_k": 100
}queryRequired original question. Multimodal may use the same text/image_url content parts as Add. Do not replace it with a final answer or use benchmark gold data.
optionsOptional. Choice text is sent as a top-level string array for multiple-choice questions, including Streaming; omitted for open questions and never contains the gold answer.
user_idRequired. Retrieve only from memory stored under this exact value.
top_kRequired. The response must not exceed this number; formal external evaluations use 100.
Fixed schemaThe current contract does not send filters, rerank, or keyword_search.
Return a JSON object whose data field is a relevance-ordered array. Return an empty array when nothing is found.
{
  "data": [{
      "id": "mem_1",
      "content": "remembered fact text",
      "score": 0.87,
      "created_at": "2026-07-01T12:00:00Z"
  }]
}dataRequired array. Do not add an items wrapper or return a top-level array.
idRequired non-empty string that stably identifies the memory.
contentRequired non-empty string; Multimodal may return text/image_url content parts. The original candidate is retained and passed to Answer.
scoreOptional number. Higher values should indicate greater relevance.
created_atOptional source or persistence timestamp.
Other fieldsThe platform reads only the declared fields above; undeclared fields such as metadata are ignored.
ERROR HANDLING
Participant endpoints should use standard HTTP status codes and return actionable errors without secrets. Platform business errors normally use {"detail":{"reason":"..."}}; HTTP 422 provides structured field-validation details.
| HTTP | Class | Typical case | Platform behavior and action |
|---|---|---|---|
400 / 422 | Contract error | An Add / Search request cannot be parsed, or a success response has missing or invalid required fields. | Not retried. Correct the schema using the error details, then rerun smoke. |
401 | Authentication failure | The Memory System Key is invalid, or the Authorization / X-Api-Key scheme does not match. | Not retried. Verify the authentication scheme and secret bound to the request. |
403 | Access denied | The key cannot call the endpoint, or the service rejects the current user_id scope. | Not retried. Review endpoint authorization and retrieval isolation. |
404 | Resource not found | An endpoint path is wrong, or a platform test, job, or result ID is invalid. | Verify the URL or resource ID. The synchronous contract has no Add Status polling. |
409 | State conflict | Add is temporarily conflicted, or a platform job is active and the Run Label is duplicated. | Add is retried with bounds; Search 409 is not retried. Wait or choose a new Run Label for platform conflicts. |
408 / 425 | Transient unavailability | The request timed out or the service is not ready. | Add and Search are retried with bounded backoff. |
429 | Rate or quota limit | The participant endpoint is capacity-limited, or a platform evaluation quota has not reset. | Endpoint calls are retried with bounds; for platform quotas, wait until the displayed availability time. |
500 / 502 / 503 / 504 | Transient service failure | The participant endpoint, gateway, or upstream dependency is temporarily unavailable. | The platform retries with backoff. Preserve the Job/Test ID and timestamp if failures persist. |
Add retries 408, 409, 425, 429, 500, 502, 503, 504, and 524. Search retries 408, 425, 429, 500, 502, 503, and 504. Network timeouts and transport failures are also eligible.
Even with HTTP 200, the stage fails if Add omits success=true or mis-echoes an ID, or if Search omits the data array or an item lacks id / content.
DATA, SECURITY & PRIVACY
Participant endpoints receive only the memory chunks, user/session identifiers, and retrieval questions needed for the current job. Gold answers, scoring criteria, and bulk dataset downloads are not provided.
user_id is the sole Search-isolation field and must match exactly during storage and retrieval. session_id is only for source-session organization. Cross-user_id retrieval is prohibited.
The Memory System Key is submitted through a controlled request flow and stored encrypted; job metadata contains only an opaque reference. Secrets do not appear in email, public rankings, or public API responses.
The platform connects only to network-validated public HTTP(S) endpoints and rejects URLs with embedded credentials or targets resolving to private, loopback, or link-local addresses.
The platform retains request outcomes, latency, errors, returned memories, and contract-validation evidence required to verify evaluation integrity and public eligibility.
Private jobs and results are visible only to the bound Leaderboard API Key. The public board shows approved systems, versions, scores, and required evaluation metadata.
Evaluation data and derived copies may be used only to complete the current job. Do not use them for training, fine-tuning, product analytics, dataset reconstruction, or redistribution. Restrict access to authorized personnel, avoid unnecessary payload logging, and delete the data within 30 days after job completion unless the platform approves another retention period in writing.
EVALUATION & RESULTS
Each chunk must be persisted and searchable before its HTTP 200 response.
The platform validates the data array, required fields, and Top K, then accepts candidates in participant order.
Valid candidate memories enter the locked platform Answer model and prompt workflow.
The platform applies fixed scoring contracts by question type and aggregates dataset and Overall results.
After completion, the bound API Key can inspect run status, breakdowns, error summaries, and job metadata.
An eligible full result creates a public submission only after qualification checks and review.
The result must come from a successful full run on the fixed suite; every evaluation task must succeed; the Answer model, evaluation contract, pipeline code hash, dataset bundle hashes, and question counts must be complete and match the current release baseline; and the result must be unique and pass platform review.
BENCHMARK SUITE
Browse benchmark datasets by dimension. Each card links to its source repository with task format, metrics, and evaluation notes.
150 software-engineering tasks run under relevant and noisy memory conditions, for 300 scored attempts.
Not currently used as the scored AML Coding benchmark.
第二期文本、代码与多模态赛道统一通过参赛方自行部署的 Add / Search API 接入。请按本页接口格式完成实现,申请并绑定评测 Key,通过 Smoke 后即可提交 Full 正式评测。
请在下方选择赛道格式;多模态会把文本与图片按顺序直接放入 messages[].content。
{
  "request_id": "eval:<run_id>:locomo_refined:conv-0:chunk-0",
  "messages": [{
    "role": "user",
    "timestamp": 1704067200000,
    "content": "raw memory text"
  }],
  "user_id": "eval:<run_id>:locomo:conv-0",
  "session_id": "eval:<run_id>:sample:0"
}
{
"request_id": "eval:<run_id>:multimodal:conv-0:chunk-0",
"messages": [{
"role": "user",
"timestamp": 1704067200000,
"content": [
{"type": "text", "text": "caption or text evidence"},
{"type": "image_url", "image_url": {
"url": "data:image/jpeg;base64,..."
}}
]
}],
"user_id": "eval:<run_id>:multimodal:conv-0",
"session_id": "eval:<run_id>:sample:0"
}文本、代码与多模态使用相同的响应格式。
{
  "success": true,
  "request_id": "eval:<run_id>:locomo_refined:conv-0:chunk-0",
  "user_id": "eval:<run_id>:locomo:conv-0",
  "session_id": "eval:<run_id>:sample:0"
}请在下方选择赛道格式;多模态 query 使用相同的有序 ContentPart[] 结构。
{
  "query": "Which answer best matches the memory?",
  "options": ["A. First answer", "B. Second answer"],
  "user_id": "eval:<run_id>:locomo:conv-0",
  "top_k": 100
}
{
"query": [
{"type": "text", "text": "Which answer matches this image?"},
{"type": "image_url", "image_url": {
"url": "data:image/png;base64,..."
}}
],
"options": ["A. First answer", "B. Second answer"],
"user_id": "eval:<run_id>:multimodal:conv-0",
"top_k": 100
}请按参赛赛道选择响应格式;多模态结果可在 data[].content 中返回有序文本与图片。
{
  "data": [{
    "id": "mem_123",
    "content": "remembered fact text",
    "score": 0.87,
    "created_at": "2026-07-01T12:00:00Z"
  }]
}
{
"data": [{
"id": "mem_123",
"content": [
{"type": "text", "text": "remembered fact text"},
{"type": "image_url", "image_url": {
"url": "data:image/webp;base64,..."
}}
],
"score": 0.87,
"created_at": "2026-07-01T12:00:00Z"
}]
}每次评测运行期间,你的 API 会接收基准内容。
你的 API 会接收评测记忆与问题。
这些数据仅限用于本次评测,不得用于训练、额外分析或共享。
请保持数据私密,避免留存日志,并在运行结束后 30 天内删除。
通过简明的页面地图,帮助用户在接口准备完成后快速找到下一步入口。
查看平台概览与基准预览。
按赛道查看公开排名。
验证 Key、启动评测任务,并查看私有结果与归因。
查看用户流程、API 契约、安全要求与结果发布规则。
提交包含任务说明、数据来源、数据包与授权信息的基准提案。
Help extend the Agent Memory Leaderboard by proposing a well-documented benchmark. Include the dataset context, evaluation goal, and provenance so reviewers can assess fit, safety, and reproducibility.